NVIDIA L4 vs A100 vs H100 em 2026: guia de compra de GPU para inferência
A conversa sobre GPU na maioria das reuniões de compras empresariais mudou. Há dois anos, a pergunta era qual acelerador comprar para treino. Em 2026, a pergunta mais frequente é qual acelerador comprar parainferência— e a resposta muitas vezes não é a placa mais recente nem a maior.
Essa mudança tem consequências orçamentais reais. Uma única placa H100 80GB PCIe situa-se entre $25,000 e $32,200 nos canais atuais. Uma L4 24GB situa-se entre $2,492 e $4,040. Separa-as cerca de uma ordem de magnitude no preço e, para uma parte significativa das cargas de inferência em produção, a placa mais barata entrega o nível de serviço de que realmente precisa.
Este guia compara os três aceleradores NVIDIA que mais compradores empresariais especificam em 2026 —L4, A100 40GB e H100 80GB— com base em preços de canal registados, e define que cargas de trabalho justificam cada nível.
Os três níveis e o que os distingue
As três placas abaixo também estão disponíveis como peças avulsas:NVIDIA L4 24GB,A100 40GBeH100 80GB— e os compradores que estejam a avaliar a escolha de CPU para os mesmos servidores devem ler o nossoguia de CPU para inferência de IA.
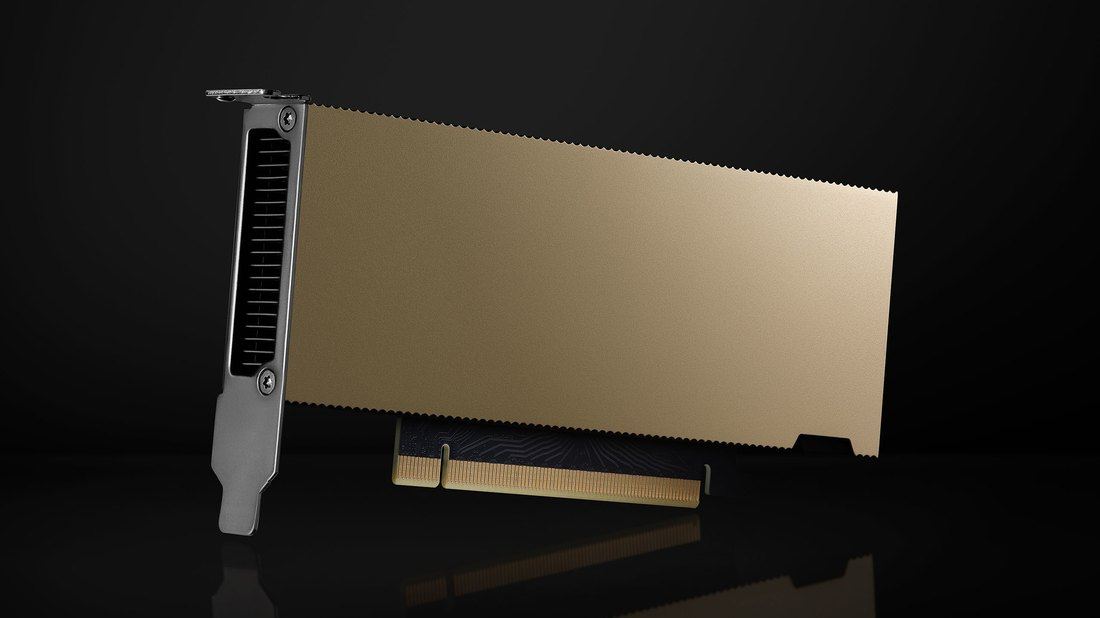
NVIDIA L4 24GBé uma placa PCIe de 72W concebida para a eficiência e não para o débito máximo. Ocupa uma ranhura de servidor padrão sem alimentação auxiliar, o que significa que pode ser adicionada a servidores 2U existentes sem redesenhar a alimentação ou o arrefecimento. Para transcodificação de vídeo, modelos de linguagem mais pequenos, serviço de recomendações e inferência na periferia, é o líder de capacidade por watt nesta comparação, por uma margem ampla.
NVIDIA A100 40GBé o cavalo de batalha do data center da geração anterior. A produção terminou em 2024, pelo que o que circula hoje é stock existente e oferta do mercado secundário. Isso faz da A100 40GB uma peça descontinuada mas ainda bem suportada, com o comportamento de preços de um produto em fim de vida e não de um produto atual.
NVIDIA H100 80GBé a gama alta atual: a maior reserva de memória, a maior largura de banda e o maior débito das três. É também a única das três em que a disponibilidade, e não o preço, é frequentemente a restrição decisiva.
O que os dados de preços de 2026 mostram
Com base nos preços pedidos registados nos canais dos EUA, da UE e da APAC em setembro de 2026:
| GPU | Memória | Preço de canal (novo) | Mercado secundário |
|---|---|---|---|
| NVIDIA L4 | 24GB | $2,492–$4,040 (mediana ≈ $2,950) | — |
| NVIDIA A100 40GB | 40GB | — | $3,150–$5,870 (intervalo registado $5,500–$7,900) |
| NVIDIA H100 80GB PCIe | 80GB | $25,000–$32,200 | ≈ $28,000 |
Duas observações são relevantes para o planeamento orçamental.
A L4 e a A100 40GB convergiram em preço.Uma L4 nova e uma A100 40GB usada situam-se agora em intervalos sobrepostos. Isso é invulgar —normalmente a arquitetura mais recente tem um prémio— e reflete o facto de a oferta de A100 ser finita e estar a ser cotada como inventário legado, enquanto a L4 continua em produção ativa.
O preço da H100 está noutra ordem de magnitude e a amostra é escassa.O nosso intervalo registado para a H100 PCIe baseia-se num número reduzido de anúncios e deve ser tratado como indicativo, e não como um preço de equilíbrio de mercado consolidado. As variantes SXM5 situam-se ainda mais acima. Os compradores devem contar com cotações da H100 a mover-se com a alocação e não com o preço de tabela.
Ajustar a placa à carga de trabalho
O erro mais caro na compra de GPU para inferência é comprar pela classificação de benchmarks em vez de pela carga de trabalho. As três placas correspondem a tarefas genuinamente diferentes.
Quando a L4 é a resposta certa
A L4 é a escolha correta quando a carga de trabalho consiste emmuitas inferências simultâneas e de dimensão moderadae não algumas de grande dimensão. A transcodificação de vídeo e os pipelines analíticos, o serviço de embeddings e recuperação, os modelos de recomendação, os modelos de linguagem pequenos e médios e a inferência em locais de periferia ou sucursais encaixam aqui. O envelope de 72W é a vantagem decisiva: significa densidade —várias placas por servidor, em servidores que já possui—.
Se o seu modelo cabe confortavelmente em 24GB e está a servir muitos pedidos em vez de empurrar a fronteira da dimensão do modelo, pagar preços de H100 é comprar débito que não conseguirá usar.
Onde a A100 40GB ainda justifica o seu lugar
A A100 40GB continua a ser uma compra sensata para organizações que precisam de mais memória e largura de banda do que uma L4 oferece, mas que não conseguem justificar os preços atuais da H100. Modelos de linguagem maiores, treino e afinação combinados com inferência e cargas HPC que beneficiam do perfil de largura de banda da A100 qualificam-se.
A ressalva é o ciclo de vida. A A100 40GB está fora de produção; tanto o horizonte de suporte como o valor de revenda diminuem a partir daqui. Se está a comprar A100 hoje, compre-a para uma carga de trabalho que consiga migrar e confirme a proveniência e a saúde da placa: as GPU do mercado secundário precisam de verificação tanto como os discos do mercado secundário.
Quando a H100 é inevitável
A H100 80GB é a resposta quando a reserva de memória de 80GB é um requisito e não uma preferência: modelos grandes que não cabem em 40GB, serviço de alto débito em que as placas mais pequenas não conseguem cumprir os objetivos de latência e qualquer ambiente em que se espera que a carga de trabalho cresça até tirar partido da placa ao longo da sua vida útil.
Se está a especificar H100, trate o prazo de entrega e a alocação como o principal risco de planeamento. Orçamente a placa e o calendário de forma independente.
A questão da plataforma de servidor
As GPU raramente são compradas isoladamente e a decisão de plataforma condiciona muitas vezes a decisão de GPU mais do que o inverso.
O envelope de 72W da L4 significa que pode entrar num servidor 2U padrão sem alimentação auxiliar —incluindo muitas plataformas da geração atual e da anterior que já estão em serviço. Este é o caminho de menor atrito para acrescentar capacidade de inferência a um parque existente.
Tanto a A100 como a H100 exigem bastante mais margem de alimentação e arrefecimento e, tipicamente, uma plataforma concebida para elas: topologia PCIe ou SXM adequada, fluxo de ar suficiente e, no caso da H100, um aprovisionamento elétrico que pode exigir uma conversa sobre as instalações e não apenas uma escolha de servidor. Quando os compradores nos pedem para comparar preços de GPU, a resposta honesta passa muitas vezes por comparar configurações de servidor completas.
Perguntas frequentes
Uma L4 é suficiente para inferência de LLM em produção ou preciso de uma A100 ou H100?
Para modelos pequenos e médios que cabem em 24GB e para o serviço de alta concorrência de pedidos moderados, uma L4 é frequentemente suficiente e drasticamente mais barata de comprar e operar. A A100 ou a H100 tornam-se necessárias quando o próprio modelo ultrapassa os 24GB, quando precisa de afinar além de servir, ou quando a placa mais pequena não consegue cumprir os objetivos de latência em alto débito. Meça a pegada real do seu modelo e a sua concorrência antes de optar por defeito pela opção maior.
Porque é que uma A100 40GB usada custa quase como uma L4 nova?
Porque a A100 40GB está fora de produção e a sua oferta remanescente é finita, enquanto a L4 continua em produção ativa com fluxo contínuo de canal. A convergência é um artefacto da oferta e não um sinal de que as duas placas sejam equivalentes: servem perfis de carga de trabalho diferentes e a L4, mais recente, tem um horizonte de suporte mais longo.
Que GPU devo escolher se também quiser afinar modelos?
A A100 40GB ou a H100 80GB. A L4 está orientada para a inferência e para cargas de trabalho mais leves; a afinação de modelos maiores é onde importam os barramentos de memória mais largos e as maiores reservas de memória da A100 e da H100. Se precisar de ambas no mesmo ambiente, a reserva de 80GB da H100 oferece a maior margem, a um custo correspondente.
Devo comprar GPU recondicionadas ou usadas?
Pode fazer sentido para cargas de trabalho secundárias, desde que a proveniência e a saúde sejam verificáveis e o revendedor forneça garantia. As GPU de data center são geralmente mais duráveis do que as suas congéneres de consumo, mas o mercado secundário inclui placas com históricos desconhecidos. Peça as mesmas provas que pediria para armazenamento: a origem da placa, o seu histórico de funcionamento quando disponível e os termos de garantia por escrito.
Podem fornecer GPU como parte de uma configuração de servidor completa?
Sim. Obtemos NVIDIA L4, A100 40GB e H100 80GB juntamente com plataformas de servidor Dell PowerEdge, HPE ProLiant e Lenovo ThinkSystem a partir do nosso armazém de Hong Kong, para que os compradores possam especificar uma configuração completa e validada em vez de adquirir placas e chassis separadamente. Envie-nos o seu requisito de carga de trabalho e proporemos a configuração e o preço.
O nosso veredicto para 2026
Não opte por defeito pela placa maior. Para cargas de inferência e vídeo de alta concorrência e modelos moderados, aL4é a compra certa em 2026 e o envelope de 72W faz dela a única das três que pode acrescentar a um servidor existente sem uma decisão de plataforma. AA100 40GBcontinua válida para modelos maiores e trabalho misto de treino e inferência, com a ressalva de que está em fim de vida e deve ser comprada para uma carga de trabalho que consiga migrar. AH100 80GBjustifica-se quando a reserva de 80GB é um requisito inegociável — e, quando o é, planeie em torno da alocação e do prazo de entrega, não do preço de tabela.
Fale connosco sobre os seus requisitos de GPU
A HKCHL armazena e obtém aceleradores NVIDIA L4, A100 e H100, isoladamente ou como parte de configurações de servidor completas e validadas, a partir do nosso armazém de Hong Kong, com envio para todo o mundo. Envie-nos a pegada do seu modelo, o objetivo de concorrência e as restrições de plataforma e responderemos com uma configuração e um orçamento, normalmente em 12 horas.
Precisa de preços atuais para uma GPU de inferência ou um servidor GPU completo? Obtemos e testamos integralmente servidores empresariais, GPU, armazenamento e memória ECC DDR4/DDR5 a partir do nosso armazém de Hong Kong. Contacte-nos com os seus requisitos: respondemos em 12 horas.