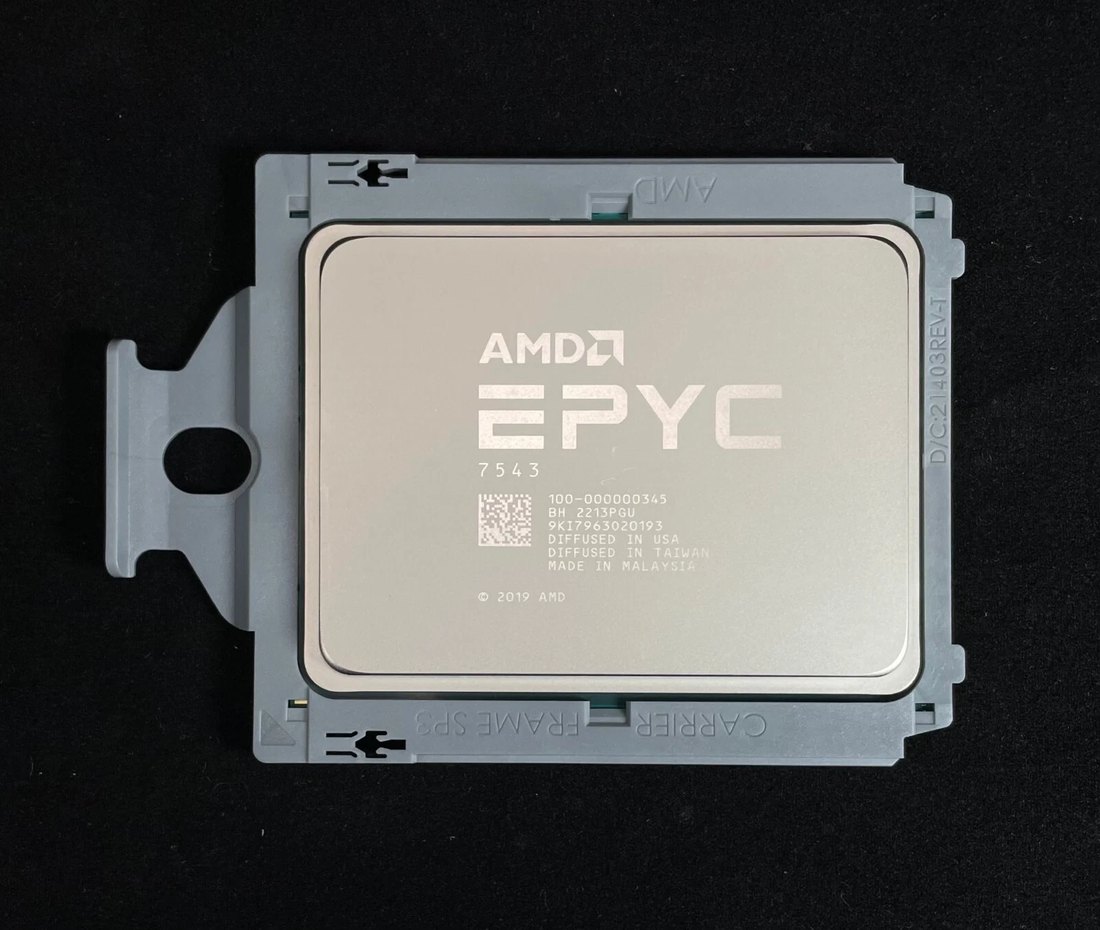
A maioria das conversas sobre infraestrutura de IA começa e termina nas GPUs. Esse foco é compreensível — os aceleradores realizam a maior parte da matemática do modelo. Mas cada pedido de inferência também passa por uma CPU: ela alimenta o acelerador, pré-processa a entrada, executa a lógica de encaminhamento e serve modelos pequenos inteiramente por si só. ACPU para inferência de IAé uma das decisões mais mal dimensionadas na aquisição de IA e o lugar mais fácil para gastar demais ou ficar abaixo do orçamento.
Com base na nossa observação do mercado em implementações empresariais de inferência, a escolha da CPU determina silenciosamente três coisas: quanto tempo de inatividade do acelerador tolera, quantos pedidos de modelos pequenos serve sem qualquer GPU e quão preparada para o futuro está a sua topologia de memória e PCIe. Este guia cobre como selecionar e obter umaCPU para inferência de IAcargas de trabalho em 2026.
Porque é que a CPU importa na inferência de IA
A inferência é fundamentalmente diferente do treino. O treino é um exercício de computação paralela sustentada. A inferência é sensível à latência, orientada por pedidos e altamente variável. As GPUs são excelentes na matemática matricial densa de um único modelo grande, mas um serviço de inferência em produção gasta uma fração surpreendente do seu tempo em trabalho que nunca toca o acelerador:
- Pré e pós-processamento de pedidos.A tokenização, as pesquisas de embeddings, a análise de saída e o encaminhamento de API são todos executados na CPU.
- Alimentação de dados.Uma GPU sem dados fica inativa a uma fração do seu potencial. A largura de banda de memória e o throughput de PCIe do lado da CPU determinam a rapidez com que o acelerador é alimentado.
- Servir modelos pequenos.Muitas chamadas de inferência em produção são modelos pequenos — classificação, extração, reranking — onde a latência e o custo da GPU não se justificam e a CPU sozinha é mais rápida de ponta a ponta.
- Orquestação de lotes.Os agendadores, a gestão de KV-cache e o isolamento multi-inquilino são executados no processador anfitrião.
O que procurar numa CPU de inferência
Nem toda CPU de servidor é igualmente boa em trabalho adjacente à inferência. Priorize estas cinco características:
- Largura de banda de memória.Na via da CPU, a inferência está limitada pela latência e pela largura de banda da memória. DDR4 de oito canais ou DDR5 de doze canais importam muito mais do que o número bruto de núcleos em muitas cargas de trabalho de serviço.
- Altas frequências de single-thread e boost.O pré-processamento e a latência dos modelos pequenos recompensam núcleos rápidos em vez do mero número de núcleos.
- Suporte de instruções de IA.O Intel AMX (Advanced Matrix Extensions) em Xeon de 4.ª/5.ª geração e o suporte AMD AVX-512/BF16 em EPYC dão à CPU uma capacidade real de inferência no chip para cargas de trabalho INT8/BF16.
- Lanes PCIe.Lanes Gen4/Gen5 suficientes para ligar aceleradores, armazenamento NVMe e NICs de alto throughput sem contenção.
- Número de núcleos para consolidação.Se o nó também executa serviços colocados, a elevada densidade de núcleos (64–96 núcleos) permite que um único host suporte a inferência e o stack circundante.
EPYC vs Xeon como CPU de inferência de IA
As duas plataformas x86 abordam o suporte de inferência de forma diferente, e ambas são legítimas — a escolha certa depende da sua mistura de cargas de trabalho e da base de plataforma instalada.
O AMD EPYC (Genoa e Milan) enfatiza a largura de banda de memória e a densidade de núcleos.O DDR5 de 12 canais do Genoa oferece cerca de 50% mais largura de banda de memória do que uma plataforma comparável de canal duplo, o que reduz diretamente a falta de dados do acelerador e acelera o serviço de modelos pequenos apenas com CPU. SKUs de muitos núcleos, como oEPYC 7763(64 núcleos, Milan) ou peças Genoa 9004 consolidam a inferência e o stack circundante num único host. O suporte AVX-512 com BF16 em EPYC cobre claramente a inferência INT8/BF16 na CPU.
O Intel Xeon (4.ª/5.ª geração) traz o AMX para a mesa.O AMX é uma unidade matricial dedicada no die que acelera operações GEMM INT8/BF16 — o núcleo da inferência transformer — sem acelerador discreto. Um Xeon de 5.ª geração com 32 núcleos a executar AMX pode servir cargas de trabalho INT8 substanciais apenas com CPU, razão pela qual a economia da inferência apenas com CPU mudou para modelos pequenos e médios.
Na prática, as frotas mistas são comuns: AMD EPYC para nós de inferência de alta densidade e alta largura de banda, e Xeon onde o AMX e as ferramentas Intel existentes se encaixam melhor. As nossas linhasAMD EPYCeIntel Xeoncobrem ambas peças recondicionadas testadas.
Inferência apenas com CPU: quando faz sentido
A carga de trabalho de IA mais rentável é a que nunca compra uma GPU. A inferência apenas com CPU é cada vez mais prática em quatro situações:
- Modelos pequenos e médios— modelos de classificação, reranking, extração e encoder que correm em milissegundos numa CPU de servidor moderna com AMX ou AVX-512/BF16.
- Cargas de trabalho de alto throughput e tolerantes à latência— pontuação por lotes onde o throughput agregado vence a latência por pedido.
- Localizações de edge e filiais— onde a energia, a refrigeração e o custo da GPU são proibitivos e o tamanho do modelo é modesto.
- Excedente de GPU e autoscaling— absorvendo picos sem provisionar mais aceleradores.
Se a sua mistura de inferência é 70% de modelos pequenos, umaCPU para inferência de IAdevidamente dimensionada pode servir essa maioria sem qualquer gasto em GPU — reservando aceleradores para a minoria de modelos grandes. Esta é a maior alavanca orçamental da arquitetura de inferência moderna.
Construir um nó de inferência equilibrado
Quando se combinam CPUs com GPUs, a proporção e a topologia importam. A nossa experiência comservidores GPUaponta para algumas regras práticas:
- Ajuste a largura de banda da CPU ao número de aceleradores.Uma plataforma de socket único e 8 canais é suficiente para uma ou duas GPUs de gama média; os nós de alta densidade (4–8 GPUs) querem uma CPU de 12 canais ou de socket duplo com largura de banda de memória máxima.
- Reserve lanes PCIe para aceleradores e armazenamento.Confirme que a CPU fornece lanes Gen5 para GPU e NVMe sem partilha.
- Dimensione a memória para KV-cache e serviço.O serviço de inferência consome muita memória; compre capacidade DDR4/DDR5 generosamente em relação à memória de GPU.
- Deixe margem.Uma margem de utilização de CPU de 15–20% absorve picos de pedidos e sobrecarga de orquestação sem privar a GPU de dados.
Exemplos de dimensionamento: dois nós de inferência realistas
Para tornar a orientação concreta, estes são dois arquétipos de nó que vemos repetidamente em frotas de inferência em produção. O dimensionamento varia conforme o modelo e o tráfego, mas a forma da construção é consistente.
Arquétipo A — nó de serviço INT8 apenas com CPU.Para cargas de classificação, reranking e encoders pequenos com concorrência moderada, um nó de socket único com um Xeon de 5.ª geração de 32 núcleos (com AMX) ou uma peça classe EPYC 7763 Milan de 64 núcleos, 128GB de memória e duas unidades NVMe serve dezenas de milhares de pedidos por minuto sem qualquer acelerador. O custo total da plataforma é uma fração de um rack com GPU, e o consumo de energia mantém-se abaixo de 600W em plena carga.
Arquétipo B — nó de geração suportado por GPU.Para geração LLM com dois a quatro aceleradores, use uma CPU de socket duplo ou de socket único de 12 canais com largura de banda de memória máxima, 256GB+ de memória de sistema para KV-cache e sobrecarga de serviço, lanes PCIe Gen5 dedicadas às GPUs e um segundo nível NVMe para os pesos do modelo. Aqui a CPU existe para manter os aceleradores alimentados: a largura de banda e a topologia PCIe estão acima do número de núcleos.
Ambos os arquétipos partilham um princípio de design: dimensione a plataforma para a via de dados, não apenas para a computação. O serviço de inferência é um pipeline — análise de entrada, matemática do acelerador, streaming de saída e armazenamento tocam todos a CPU. Quando o pipeline está equilibrado, a utilização sobe e o custo por pedido cai; quando não está, o componente mais caro do rack fica inativo.
Se não tem a certeza de qual arquétipo se adequa à sua carga de trabalho, a via prática é perfilar: meça os pedidos concorrentes, o tamanho do modelo e os objetivos de latência, e depois mapeie-os para requisitos de CPU, memória e acelerador. A nossa equipa acompanha regularmente os compradores neste exercício e pode sugerir uma configuração recondicionada testada que corresponda ao perfil.
Meça antes de comprar.A forma mais barata de validar uma escolha de CPU é a telemetria: execute pedidos representativos, capture a utilização de CPU, a saturação da largura de banda de memória e o throughput de PCIe, e compare o perfil com o seu objetivo de latência. Na nossa experiência a apoiar compradores empresariais, a maioria das surpresas de desempenho na inferência remonta à contenção de largura de banda de memória ou PCIe, não ao número bruto de núcleos — razão pela qual o dimensionamento primeiro pela largura de banda supera consistentemente o dimensionamento primeiro pelos núcleos.
Mantenha o firmware atualizado.O desempenho do AMX e do AVX-512 depende das revisões de microcódigo e BIOS. Um nó recondicionado deve ser atualizado para o firmware suportado mais recente antes da implementação; um microcódigo desatualizado pode desativar silenciosamente os próprios conjuntos de instruções que justificam a escolha da CPU. Atualizamos o firmware como parte do nosso processo de teste e registamos a revisão no relatório de diagnóstico da unidade.
Planeie a saída.O hardware de inferência deprecia-se de forma previsível, e o mesmo ciclo de renovação de três a cinco anos que tornou acessíveis as peças EPYC e Xeon usadas de hoje aplicar-se-á ao nó que construir agora. Escolher uma plataforma com um mercado secundário profundo — SKUs de alto volume em sockets amplamente implementados — preserva o valor de revenda e as opções de atualização futuras. Esta é mais uma razão pela qual as peças EPYC e Xeon comuns superam SKUs exóticos ou de nicho ao longo de um ciclo completo de propriedade.
Comprar CPUs de inferência recondicionadas
A economia da inferência recompensa o hardware recondicionado mais do que o treino: as cargas de trabalho são menores, os objetivos de latência são atingidos facilmente por silício de geração anterior e os requisitos de plataforma de memória/PCIe já estão maduros. Obter peças EPYC e Xeon descomissionadas de forma responsável exige a mesma disciplina de qualquer compra de CPU de servidor — verificação OPN, steppings emparelhados para 2P, teste de stress de todos os núcleos e registo térmico. Um Milan de 64 núcleos ou um Xeon de 5.ª geração de 32 núcleos usado, com a configuração de memória certa, lida regularmente com misturas de inferência de produção a uma fração do custo de um rack novo.
A HKCHL fornece processadores EPYC e Xeon recondicionados e testados para builds de inferência, confirma a compatibilidade da plataforma e pode combinar memória e armazenamento para completar o nó. Se está a dimensionar uma implementação de inferência e quer uma segunda opinião prática sobre a seleção ou o fornecimento da CPU, a nossa equipa tem todo o gosto em discutir os seus requisitos e traçar uma configuração adequada ao orçamento — seja um nó de serviço apenas com CPU ou um build equilibrado suportado por GPU.Contacte-nospara uma consulta e uma cotação.