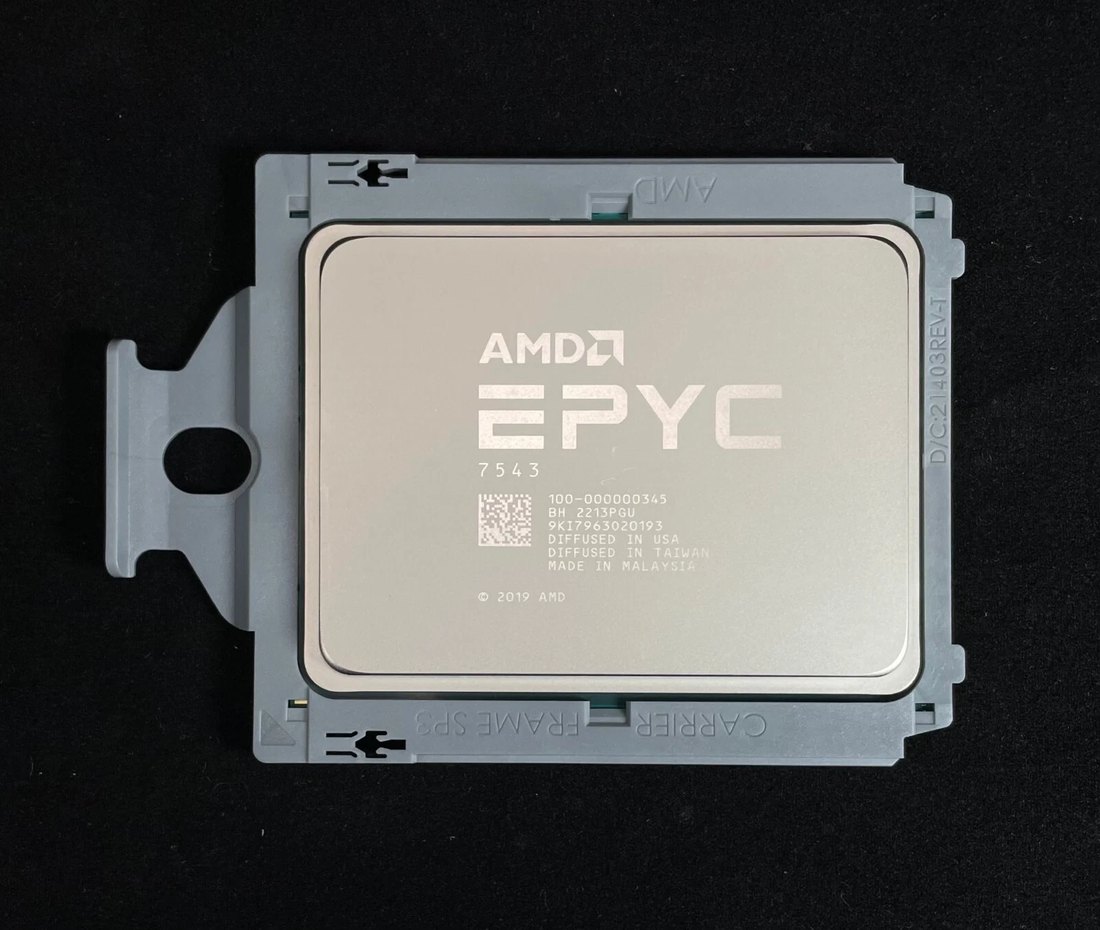
La plupart des discussions sur l'infrastructure d'IA commencent et se terminent par les GPU. Cette focalisation est compréhensible — les accélérateurs effectuent l'essentiel des calculs de modèles. Mais chaque requête d'inférence passe aussi par un CPU : il alimente l'accélérateur, prétraite l'entrée, exécute la logique de routage et sert entièrement les petits modèles. LeCPU pour l'inférence IAest l'une des décisions les plus sous-dimensionnées de l'achat d'IA, et l'endroit le plus facile pour dépasser son budget ou le sous-estimer.
D'après notre observation du marché sur les déploiements d'inférence d'entreprise, le choix du CPU détermine discrètement trois choses : combien de temps d'inactivité de l'accélérateur vous tolérez, combien de requêtes de petits modèles vous servez sans GPU du tout, et à quel point votre topologie mémoire et PCIe est pérenne. Ce guide explique comment sélectionner et se procurer unCPU pour l'inférence IAcharges de travail en 2026.
Pourquoi le CPU compte dans l'inférence IA
L'inférence est fondamentalement différente de l'entraînement. L'entraînement est un exercice de calcul parallèle soutenu. L'inférence est sensible à la latence, pilotée par les requêtes et très variable. Les GPU excellent dans le calcul matriciel dense d'un seul grand modèle, mais un service d'inférence en production consacre une fraction surprenante de son temps à un travail qui ne touche jamais l'accélérateur :
- Pré- et post-traitement des requêtes.La tokenisation, les recherches d'embeddings, l'analyse des sorties et le routage des API s'exécutent tous sur le CPU.
- Alimentation en données.Un GPU privé de données reste inactif à une fraction de son potentiel. La bande passante mémoire et le débit PCIe côté CPU déterminent la vitesse à laquelle l'accélérateur est alimenté.
- Service des petits modèles.De nombreux appels d'inférence en production concernent de petits modèles — classification, extraction, reclassement — où la latence et le coût du GPU ne se justifient pas et où le CPU seul est plus rapide de bout en bout.
- Orchestration par lots.Les planificateurs, la gestion du KV-cache et l'isolation multi-locataires s'exécutent sur le processeur hôte.
Que rechercher dans un CPU d'inférence
Tous les CPU serveur ne sont pas également bons pour les tâches liées à l'inférence. Privilégiez ces cinq caractéristiques :
- Bande passante mémoire.Sur le chemin CPU, l'inférence est limitée par la latence et la bande passante mémoire. Le DDR4 à huit canaux ou le DDR5 à douze canaux comptent bien plus que le nombre brut de cœurs pour de nombreuses charges de travail de service.
- Fréquences élevées en mono-thread et en boost.Le prétraitement et la latence des petits modèles récompensent les cœurs rapides plutôt que le simple nombre de cœurs.
- Prise en charge des instructions IA.L'Intel AMX (Advanced Matrix Extensions) sur Xeon 4e/5e génération et la prise en charge AMD AVX-512/BF16 sur EPYC donnent au CPU une véritable capacité d'inférence intégrée pour les charges de travail INT8/BF16.
- Lignes PCIe.Assez de lignes Gen4/Gen5 pour connecter accélérateurs, stockage NVMe et NIC haut débit sans contention.
- Nombre de cœurs pour la consolidation.Si le nœud exécute aussi des services colocalisés, une forte densité de cœurs (64 à 96 cœurs) permet à un seul hôte de porter l'inférence et la pile environnante.
EPYC vs Xeon comme CPU d'inférence IA
Les deux plateformes x86 abordent la prise en charge de l'inférence différemment, et les deux sont légitimes — le bon choix dépend de votre mix de charges de travail et de votre base de plateforme installée.
L'AMD EPYC (Genoa et Milan) met l'accent sur la bande passante mémoire et la densité de cœurs.Le DDR5 à 12 canaux de Genoa offre environ 50 % de bande passante mémoire en plus qu'une plateforme comparable à double canal, ce qui réduit directement la privation de données de l'accélérateur et accélère le service des petits modèles sur CPU seul. Les SKU à nombreux cœurs, comme leEPYC 7763(64 cœurs, Milan) ou les pièces Genoa 9004 consolident l'inférence et la pile environnante dans un seul hôte. La prise en charge AVX-512 avec BF16 sur EPYC couvre proprement l'inférence INT8/BF16 sur CPU.
L'Intel Xeon (4e/5e génération) apporte l'AMX.L'AMX est une unité matricielle dédiée sur la puce qui accélère les opérations GEMM INT8/BF16 — le cœur de l'inférence transformer — sans accélérateur discret. Un Xeon 5e génération 32 cœurs exécutant l'AMX peut servir des charges de travail INT8 substantielles sur CPU seul, ce qui explique pourquoi l'économie de l'inférence sur CPU seul a changé pour les petits et moyens modèles.
En pratique, les parcs mixtes sont courants : AMD EPYC pour les nœuds d'inférence haute densité et haute bande passante, et Xeon là où l'AMX et les outils Intel existants s'intègrent mieux. Nos gammesAMD EPYCetIntel Xeoncouvrent toutes deux des pièces reconditionnées testées.
Inférence sur CPU seul : quand c'est pertinent
La charge de travail d'IA la plus rentable est celle qui n'achète jamais de GPU. L'inférence sur CPU seul est de plus en plus pratique dans quatre situations :
- Petits et moyens modèles— modèles de classification, de reclassement, d'extraction et d'encodeur qui s'exécutent en millisecondes sur un CPU serveur moderne avec AMX ou AVX-512/BF16.
- Charges de travail à haut débit et tolérantes à la latence— la notation par lots où le débit agrégé prime sur la latence par requête.
- Sites périphériques et succursales— là où la puissance, le refroidissement et le coût du GPU sont prohibitifs et où la taille du modèle est modeste.
- Débordement GPU et autoscaling— en absorbant les pics sans provisionner davantage d'accélérateurs.
Si votre mix d'inférence est composé à 70 % de petits modèles, unCPU pour l'inférence IAcorrectement dimensionné peut servir cette majorité sans aucun dépense GPU — réservant les accélérateurs à la minorité de grands modèles. C'est le plus grand levier budgétaire de l'architecture d'inférence moderne.
Construire un nœud d'inférence équilibré
Lorsque vous associez des CPU à des GPU, le ratio et la topologie comptent. Notre expérience avec lesserveurs GPUpointe vers quelques règles pratiques :
- Alignez la bande passante du CPU sur le nombre d'accélérateurs.Une plateforme monocanal à 8 canaux suffit pour une ou deux GPU de milieu de gamme ; les nœuds haute densité (4 à 8 GPU) nécessitent un CPU à 12 canaux ou bi-socket avec une bande passante mémoire maximale.
- Réservez les lignes PCIe pour les accélérateurs et le stockage.Confirmez que le CPU fournit des lignes Gen5 pour GPU et NVMe sans partage.
- Dimensionnez la mémoire pour le KV-cache et le service.Le service d'inférence est gourmand en mémoire ; achetez de la capacité DDR4/DDR5 généreusement par rapport à la mémoire GPU.
- Prévoyez de la marge.Une marge d'utilisation CPU de 15 à 20 % absorbe les pics de requêtes et la surcharge d'orchestration sans priver le GPU de données.
Exemples de dimensionnement : deux nœuds d'inférence réalistes
Pour rendre les conseils concrets, voici deux archétypes de nœuds que nous voyons régulièrement dans les parcs d'inférence en production. Le dimensionnement varie selon le modèle et le trafic, mais la forme de la configuration reste cohérente.
Archétype A — nœud de service INT8 sur CPU seul.Pour les charges de classification, de reclassement et de petits encodeurs à concurrence modérée, un nœud monocanal avec un Xeon 5e génération 32 cœurs (avec AMX) ou une pièce de classe EPYC 7763 Milan 64 cœurs, 128 Go de mémoire et deux disques NVMe sert des dizaines de milliers de requêtes par minute sans aucun accélérateur. Le coût total de la plateforme est une fraction d'un rack équipé de GPU, et la consommation reste sous 600 W à pleine charge.
Archétype B — nœud de génération adossé à des GPU.Pour la génération LLM avec deux à quatre accélérateurs, utilisez un CPU bi-socket ou monocanal 12 canaux avec une bande passante mémoire maximale, 256 Go et plus de mémoire système pour le KV-cache et la surcharge de service, des lignes PCIe Gen5 dédiées aux GPU et un second niveau NVMe pour les poids du modèle. Ici, le CPU existe pour alimenter les accélérateurs : la bande passante et la topologie PCIe priment sur le nombre de cœurs.
Les deux archétypes partagent un principe de conception : dimensionnez la plateforme pour le chemin des données, pas seulement pour le calcul. Le service d'inférence est un pipeline — analyse d'entrée, calculs de l'accélérateur, diffusion de sortie et stockage touchent tous le CPU. Lorsque le pipeline est équilibré, l'utilisation grimpe et le coût par requête baisse ; lorsqu'il ne l'est pas, le composant le plus cher du rack reste inactif.
Si vous n'êtes pas sûr de l'archétype qui correspond à votre charge de travail, la voie pratique est de la profiler : mesurez les requêtes concurrentes, la taille du modèle et les objectifs de latence, puis traduisez-les en exigences de CPU, de mémoire et d'accélérateur. Notre équipe accompagne régulièrement les acheteurs dans cet exercice et peut suggérer une configuration reconditionnée testée qui correspond au profil.
Mesurez avant d'acheter.Le moyen le moins cher de valider un choix de CPU est la télémétrie : exécutez des requêtes représentatives, capturez l'utilisation CPU, la saturation de la bande passante mémoire et le débit PCIe, et comparez le profil à votre objectif de latence. Dans notre expérience auprès des acheteurs d'entreprise, la majorité des surprises de performance en inférence remontent à la contention de bande passante mémoire ou PCIe, pas au nombre brut de cœurs — c'est pourquoi un dimensionnement d'abord par la bande passante surpasse systématiquement un dimensionnement d'abord par les cœurs.
Gardez le firmware à jour.Les performances d'AMX et d'AVX-512 dépendent des révisions de microcode et de BIOS. Un nœud reconditionné doit être mis à jour vers le firmware pris en charge le plus récent avant le déploiement ; un microcode obsolète peut désactiver silencieusement les jeux d'instructions mêmes qui justifient le choix du CPU. Nous mettons à jour le firmware dans le cadre de notre processus de test et consignons la révision dans le rapport de diagnostic de l'unité.
Planifiez la sortie.Le matériel d'inférence se déprécie de façon prévisible, et le même cycle de renouvellement de trois à cinq ans qui a rendu abordables les pièces EPYC et Xeon d'occasion d'aujourd'hui s'appliquera au nœud que vous construisez maintenant. Choisir une plateforme avec un marché secondaire profond — des SKU à fort volume sur des sockets largement déployés — préserve la valeur de revente et les options d'évolution futures. C'est une raison de plus pour laquelle les pièces EPYC et Xeon grand public surpassent les SKU exotiques ou de niche sur un cycle de possession complet.
Acheter des CPU d'inférence reconditionnés
L'économie de l'inférence récompense le matériel reconditionné plus que l'entraînement : les charges de travail sont plus petites, les objectifs de latence sont atteints facilement par le silicium de génération précédente et les exigences de plateforme mémoire/PCIe sont déjà matures. S'approvisionner en pièces EPYC et Xeon décommissionnées de façon responsable exige la même discipline que tout achat de CPU serveur — vérification OPN, steppings appariés pour 2P, test de stress de tous les cœurs et journalisation thermique. Un Milan 64 cœurs ou un Xeon 5e génération 32 cœurs d'occasion, avec la bonne configuration mémoire, gère couramment des mixes d'inférence de production à une fraction du coût d'un rack neuf.
HKCHL fournit des processeurs EPYC et Xeon reconditionnés et testés pour les builds d'inférence, confirme la compatibilité de plateforme et peut assortir mémoire et stockage pour compléter le nœud. Si vous dimensionnez un déploiement d'inférence et souhaitez un second avis pratique sur la sélection ou l'approvisionnement du CPU, notre équipe se fera un plaisir de discuter de vos besoins et de définir une configuration adaptée au budget — qu'il s'agisse d'un nœud de service sur CPU seul ou d'une configuration équilibrée adossée à des GPU.Contactez-nouspour une consultation et un devis.