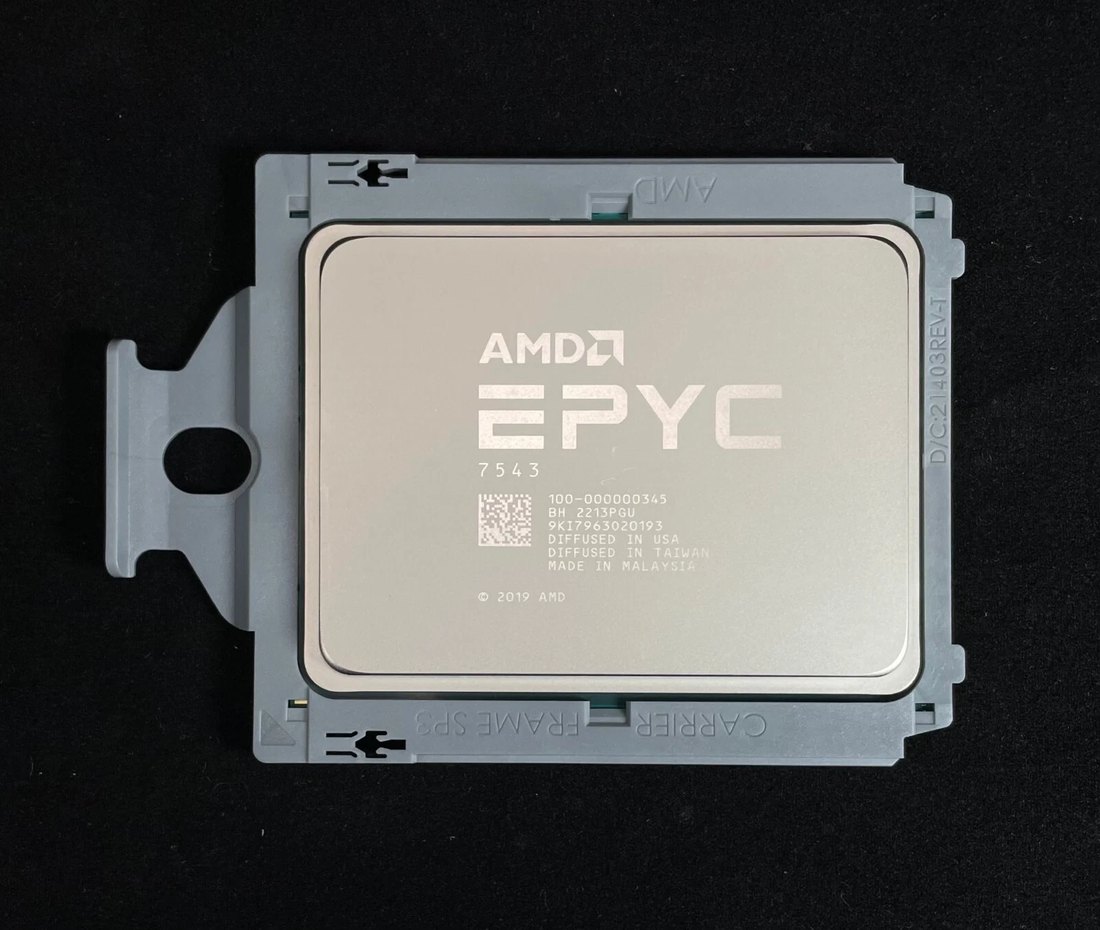
Die meisten Gespräche über KI-Infrastruktur beginnen und enden bei GPUs. Dieser Fokus ist verständlich — Beschleuniger erledigen den Großteil der Modellmathematik. Aber jede Inferenzanfrage durchläuft auch eine CPU: Sie speist den Beschleuniger, verarbeitet die Eingabe vor, führt die Routing-Logik aus und bedient kleine Modelle vollständig allein. DieCPU für KI-Inferenzist eine der am wenigsten durchdachten Entscheidungen bei der KI-Beschaffung und der leichteste Ort, um zu viel auszugeben oder zu knapp zu budgetieren.
Nach unserer Marktbeobachtung bei Enterprise-Inferenz-Deployments bestimmt die CPU-Wahl stillschweigend drei Dinge: wie viel Beschleuniger-Leerlauf Sie tolerieren, wie viele Small-Model-Anfragen Sie ganz ohne GPU bedienen und wie zukunftssicher Ihre Speicher- und PCIe-Topologie ist. Dieser Leitfaden zeigt, wie Sie eineCPU für KI-InferenzWorkloads im Jahr 2026.
Warum die CPU bei der KI-Inferenz zählt
Inferenz unterscheidet sich grundlegend vom Training. Training ist eine dauerhafte, parallele Rechenübung. Inferenz ist latenzempfindlich, anfragegetrieben und stark variabel. GPUs sind hervorragend bei der dichten Matrixmathematik eines einzelnen großen Modells, aber ein Produktions-Inferenzdienst verbringt einen überraschend großen Teil seiner Zeit mit Arbeit, die den Beschleuniger nie berührt:
- Vor- und Nachbearbeitung von Anfragen.Tokenisierung, Embedding-Abfragen, Ausgabe-Parsing und API-Routing laufen alle auf der CPU.
- Dateneinspeisung.Eine GPU, die auf Daten wartet, läuft nur mit einem Bruchteil ihres Potenzials. Speicherbandbreite und PCIe-Durchsatz auf der CPU-Seite bestimmen, wie schnell der Beschleuniger versorgt wird.
- Serving kleiner Modelle.Viele Produktions-Inferenzaufrufe sind kleine Modelle — Klassifikation, Extraktion, Reranking —, bei denen GPU-Latenz und -Kosten nicht gerechtfertigt sind und die CPU allein durchgängig schneller ist.
- Batch-Orchestrierung.Scheduler, KV-Cache-Verwaltung und Multi-Tenant-Isolation laufen auf dem Host-Prozessor.
Worauf es bei einer Inferenz-CPU ankommt
Nicht jede Server-CPU ist gleich gut für inferenznahe Arbeit geeignet. Priorisieren Sie diese fünf Eigenschaften:
- Speicherbandbreite.Inferenz ist auf dem CPU-Pfad durch Speicherlatenz und -bandbreite begrenzt. Achtkanaliges DDR4 oder zwölfkanaliges DDR5 zählen für viele Serving-Workloads weit mehr als die reine Kernzahl.
- Hohe Single-Thread- und Boost-Takte.Vorverarbeitung und Latenz kleiner Modelle belohnen schnelle Kerne mehr als die bloße Kernzahl.
- Unterstützung für KI-Instruktionen.Intel AMX (Advanced Matrix Extensions) auf Xeon der 4./5. Generation und AMD AVX-512/BF16-Support auf EPYC geben der CPU eine echte On-Chip-Inferenzfähigkeit für INT8/BF16-Workloads.
- PCIe-Lanes.Genug Gen4/Gen5-Lanes, um Beschleuniger, NVMe-Speicher und Hochdurchsatz-NICs ohne Konkurrenz anzubinden.
- Kernzahl für Konsolidierung.Wenn der Knoten auch ko-lokierte Dienste ausführt, ermöglicht eine hohe Kerndichte (64–96 Kerne), dass ein Host Inferenz und den umgebenden Stack trägt.
EPYC vs. Xeon als KI-Inferenz-CPU
Die beiden x86-Plattformen unterstützen Inferenz unterschiedlich, und beide sind legitim — die richtige Wahl hängt von Ihrer Workload-Mischung und der installierten Plattformbasis ab.
AMD EPYC (Genoa und Milan) legt den Schwerpunkt auf Speicherbandbreite und Kerndichte.Genoas 12-Kanal-DDR5 liefert etwa 50 % mehr Speicherbandbreite als eine vergleichbare Dual-Channel-Plattform, was den Beschleuniger-Hunger direkt reduziert und das CPU-only-Serving kleiner Modelle beschleunigt. High-Core-SKUs wie derEPYC 7763(64 Kerne, Milan) oder Genoa-9004-Teile konsolidieren Inferenz und den umgebenden Stack in einem Host. AVX-512 mit BF16-Support auf EPYC deckt INT8/BF16-On-CPU-Inferenz sauber ab.
Intel Xeon (4./5. Generation) bringt AMX ins Spiel.AMX ist eine dedizierte On-Die-Matrixeinheit, die INT8/BF16-GEMM-Operationen beschleunigt — den Kern der Transformer-Inferenz — ohne diskreten Beschleuniger. Ein 32-Kern-Xeon der 5. Generation mit AMX kann beträchtliche INT8-Workloads allein auf der CPU bedienen; deshalb hat sich die Wirtschaftlichkeit der CPU-only-Inferenz für kleine und mittlere Modelle verschoben.
In der Praxis sind gemischte Flotten üblich: AMD EPYC für hochdichte, hochbandbreitige Inferenzknoten und Xeon, wo AMX und vorhandene Intel-Tools besser passen. UnsereAMD EPYCundIntel XeonLinien decken beide getestete aufbereitete Teile ab.
CPU-only-Inferenz: Wann sie sinnvoll ist
Die kosteneffizienteste KI-Workload ist die, die nie eine GPU kauft. CPU-only-Inferenz wird in vier Situationen zunehmend praktikabel:
- Kleine und mittlere Modelle— Klassifikations-, Reranking-, Extraktions- und Encoder-Modelle, die auf einer modernen Server-CPU mit AMX oder AVX-512/BF16 in Millisekunden laufen.
- Hochdurchsatz-, latenz tolerante Workloads— Batch-Scoring, bei dem der aggregierte Durchsatz die Pro-Anfrage-Latenz schlägt.
- Edge- und Filialstandorte— wo GPU-Leistung, Kühlung und Kosten unerschwinglich sind und die Modellgröße bescheiden ist.
- GPU-Überlauf und Autoscaling— Spitzen werden aufgefangen, ohne weitere Beschleuniger zu provisionieren.
Wenn Ihre Inferenz-Mischung zu 70 % aus kleinen Modellen besteht, kann eineCPU für KI-Inferenzkorrekt spezifizierte CPU diese Mehrheit ohne jede GPU-Ausgabe bedienen — Beschleuniger bleiben der Minderheit großer Modelle vorbehalten. Das ist der größte Budgethebel moderner Inferenzarchitektur.
Einen ausgewogenen Inferenzknoten aufbauen
Wenn Sie CPUs mit GPUs kombinieren, zählen Verhältnis und Topologie. Unsere Erfahrung mitGPU-Servernzeigt einige Faustregeln:
- CPU-Bandbreite an die Anzahl der Beschleuniger anpassen.Eine Single-Socket-Plattform mit 8 Kanälen reicht für ein oder zwei Mittelklasse-GPUs; hochdichte Knoten (4–8 GPUs) brauchen eine 12-Kanal- oder Dual-Socket-CPU mit maximaler Speicherbandbreite.
- PCIe-Lanes für Beschleuniger und Speicher reservieren.Bestätigen Sie, dass die CPU Gen5-Lanes für GPU und NVMe ohne Teilung bereitstellt.
- Speicher für KV-Cache und Serving dimensionieren.Inferenz-Serving ist speicherintensiv; kaufen Sie DDR4/DDR5-Kapazität großzügig im Verhältnis zum GPU-Speicher.
- Lassen Sie Reserve.Ein CPU-Auslastungspuffer von 15–20 % fängt Anfragespitzen und Orchestrierungsaufwand auf, ohne die GPU hungern zu lassen.
Dimensionierungsbeispiele: Zwei realistische Inferenzknoten
Um die Empfehlungen konkret zu machen, hier zwei Knoten-Archetypen, die wir in Produktions-Inferenzflotten immer wieder sehen. Die Dimensionierung variiert je nach Modell und Verkehr, aber die Form des Aufbaus ist konsistent.
Archetyp A — CPU-only-INT8-Serving-Knoten.Für Klassifikations-, Reranking- und kleine Encoder-Workloads bei moderater Nebenläufigkeit bedient ein Single-Socket-Knoten mit einem 32-Kern-Xeon der 5. Generation (mit AMX) oder einem 64-Kern-Milan-EPYC-7763-Klassenteil, 128 GB Speicher und zwei NVMe-Laufwerken Zehntausende Anfragen pro Minute ohne jeden Beschleuniger. Die Gesamtkosten der Plattform sind ein Bruchteil eines GPU-Racks, und der Stromverbrauch bleibt unter 600 W bei Volllast.
Archetyp B — GPU-gestützter Generierungsknoten.Für LLM-Generierung mit zwei bis vier Beschleunigern verwenden Sie eine Dual-Socket- oder 12-Kanal-Single-Socket-CPU mit maximaler Speicherbandbreite, 256 GB+ Systemspeicher für KV-Cache und Serving-Overhead, PCIe-Gen5-Lanes, die den GPUs gewidmet sind, und eine zweite NVMe-Ebene für Modellgewichte. Die CPU existiert hier, um die Beschleuniger zu versorgen: Bandbreite und PCIe-Topologie stehen über der Kernzahl.
Beide Archetypen teilen ein Designprinzip: Dimensionieren Sie die Plattform für den Datenpfad, nicht nur für die Rechenleistung. Inferenz-Serving ist eine Pipeline — Eingabe-Parsing, Beschleunigermathematik, Ausgabe-Streaming und Speicher berühren alle die CPU. Ist die Pipeline ausgewogen, steigt die Auslastung und die Kosten pro Anfrage sinken; ist sie es nicht, läuft die teuerste Komponente im Rack im Leerlauf.
Wenn Sie nicht sicher sind, welcher Archetyp zu Ihrer Workload passt, ist der praktische Weg, sie zu profilen: Messen Sie gleichzeitige Anfragen, Modellgröße und Latenzziele und ordnen Sie diese dann CPU-, Speicher- und Beschleunigeranforderungen zu. Unser Team begleitet Käufer regelmäßig durch diese Übung und kann eine getestete aufbereitete Konfiguration vorschlagen, die zum Profil passt.
Messen Sie vor dem Kauf.Der günstigste Weg, eine CPU-Wahl zu validieren, ist Telemetrie: Führen Sie repräsentative Anfragen aus, erfassen Sie CPU-Auslastung, Speicherbandbreiten-Sättigung und PCIe-Durchsatz und vergleichen Sie das Profil mit Ihrem Latenzziel. Nach unserer Erfahrung mit Unternehmenskäufern führen die meisten Leistungsüberraschungen bei Inferenz auf Speicherbandbreiten- oder PCIe-Konkurrenz zurück, nicht auf die rohe Kernzahl — weshalb bandbreitenorientierte Dimensionierung durchgängig besser abschneidet als kernorientierte.
Firmware aktuell halten.AMX- und AVX-512-Leistung hängen von Mikrocode- und BIOS-Revisionen ab. Ein aufbereiteter Knoten sollte vor dem Deployment auf die neueste unterstützte Firmware aktualisiert werden; ein veralteter Mikrocode kann genau die Befehlssätze stillschweigend deaktivieren, die die CPU-Wahl rechtfertigen. Wir aktualisieren Firmware als Teil unseres Testprozesses und dokumentieren die Revision im Diagnosebericht der Einheit.
Planen Sie den Ausstieg.Inferenz-Hardware wertet vorhersehbar ab, und derselbe Drei-bis-Fünf-Jahres-Erneuerungszyklus, der heutige gebrauchte EPYC- und Xeon-Teile erschwinglich machte, gilt auch für den Knoten, den Sie jetzt bauen. Eine Plattform mit tiefem Sekundärmarkt — High-Volume-SKUs auf weit verbreiteten Sockeln — erhält den Wiederverkaufswert und künftige Upgrade-Optionen. Das ist ein weiterer Grund, warum Mainstream-EPYC- und Xeon-Teile exotische oder Nischen-SKUs über einen vollen Eigentumszyklus übertreffen.
Aufbereitete Inferenz-CPUs kaufen
Inferenz-Ökonomie belohnt aufbereitete Hardware stärker als Training: Die Workloads sind kleiner, die Latenzziele werden von Silizium der Vorgängergeneration problemlos erreicht, und die Speicher-/PCIe-Plattformanforderungen sind bereits ausgereift. Verantwortungsvolle Beschaffung ausgemusterter EPYC- und Xeon-Teile erfordert dieselbe Disziplin wie jeder Server-CPU-Kauf — OPN-Verifizierung, passende Steppings für 2P, Vollkern-Stresstests und thermisches Logging. Ein gebrauchter 64-Kern-Milan oder 32-Kern-Xeon der 5. Generation mit der richtigen Speicherkonfiguration bewältigt routinemäßig Produktions-Inferenzmixe zu einem Bruchteil der Kosten eines neuen Racks.
HKCHL liefert getestete aufbereitete EPYC- und Xeon-Prozessoren für Inferenz-Builds, bestätigt die Plattformkompatibilität und kann Speicher und Storage passend ergänzen, um den Knoten zu vervollständigen. Wenn Sie ein Inferenz-Deployment dimensionieren und eine praktische Zweitmeinung zur CPU-Auswahl oder -Beschaffung wünschen, bespricht unser Team gerne Ihre Anforderungen und entwirft eine budgetgerechte Konfiguration — ob CPU-only-Serving-Knoten oder ausgewogener GPU-gestützter Build.Kontaktieren Sie unsfür eine Beratung und ein Angebot.