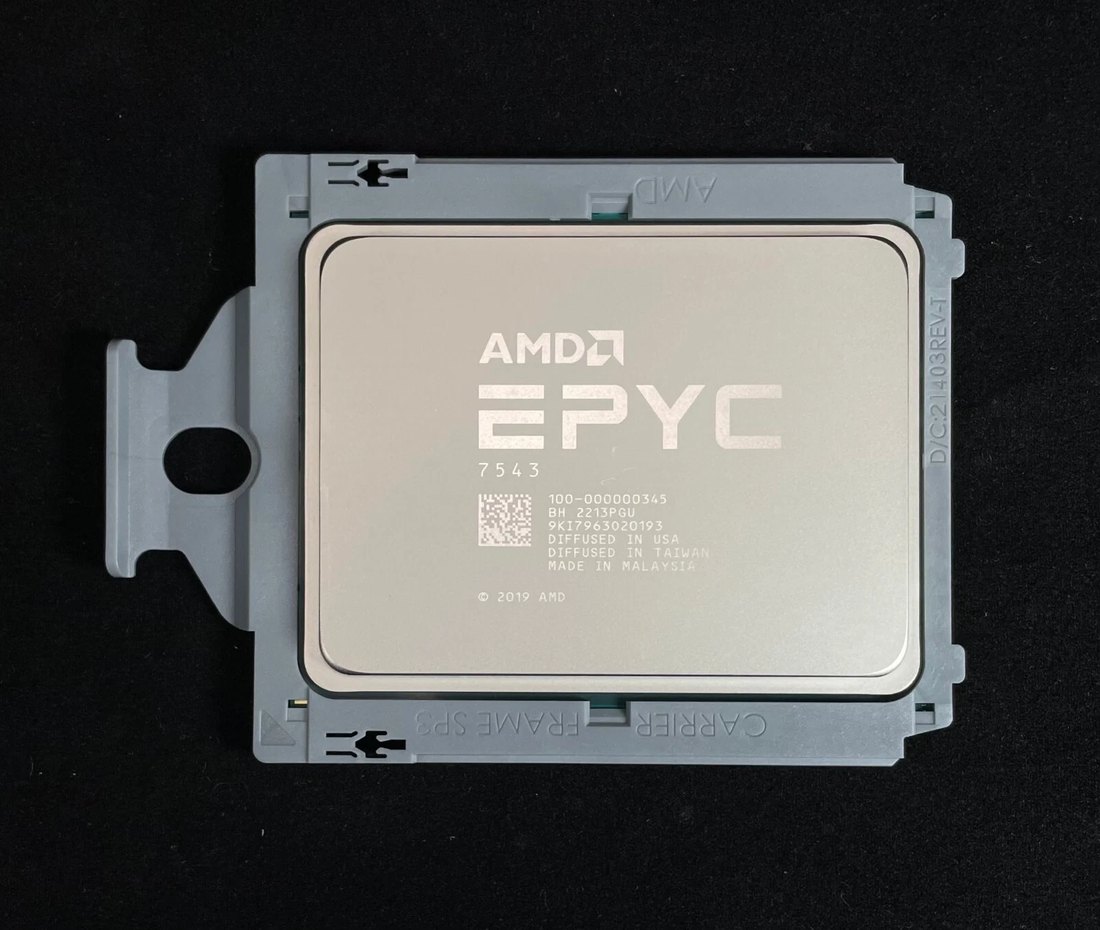
Большинство разговоров об ИИ-инфраструктуре начинаются и заканчиваются GPU. Такой фокус понятен: ускорители выполняют основную часть математики моделей. Но каждый запрос на инференс также проходит через CPU: он питает ускоритель, предобрабатывает входные данные, выполняет логику маршрутизации и полностью самостоятельно обслуживает малые модели.CPU для ИИ-инференса— одно из самых недооценённых решений при закупке ИИ-оборудования и самое лёгкое место, чтобы перерасходовать бюджет или заложить его слишком мало.
По нашим наблюдениям за рынком корпоративных развёртываний инференса, выбор CPU незаметно определяет три вещи: сколько простоя ускорителя вы терпите, сколько запросов малых моделей вы обслуживаете вообще без GPU и насколько перспективна ваша топология памяти и PCIe. Это руководство объясняет, как выбрать и закупитьCPU для ИИ-инференсанагрузок в 2026 году.
Почему CPU важен при ИИ-инференсе
Инференс принципиально отличается от обучения. Обучение — это длительная параллельная вычислительная задача. Инференс чувствителен к задержке, управляется запросами и крайне изменчив. GPU отлично справляются с плотной матричной математикой одной большой модели, но производственный сервис инференса тратит удивительно большую долю времени на работу, которая никогда не касается ускорителя:
- Предварительная и последующая обработка запросов.Токенизация, поиск эмбеддингов, разбор выходных данных и маршрутизация API выполняются на CPU.
- Подача данных.GPU, которой не хватает данных, простаивает на доле своего потенциала. Пропускная способность памяти и PCIe на стороне CPU определяют, как быстро питается ускоритель.
- Обслуживание малых моделей.Многие производственные вызовы инференса — это малые модели: классификация, извлечение, реранкинг, — где задержка и стоимость GPU не оправданы, а один только CPU быстрее от начала до конца.
- Оркестрация пакетов.Планировщики, управление KV-кэшем и изоляция мультиарендности выполняются на хост-процессоре.
Что искать в CPU для инференса
Не каждый серверный CPU одинаково хорош для задач, связанных с инференсом. Приоритезируйте пять характеристик:
- Пропускная способность памяти.На пути CPU инференс ограничен задержкой и пропускной способностью памяти. Восьмиканальный DDR4 или двенадцатиканальный DDR5 важны гораздо больше, чем сырое количество ядер, для многих сервисных нагрузок.
- Высокие тактовые частоты в однопоточном режиме и boost.Предобработка и задержка малых моделей вознаграждают быстрые ядра в большей степени, чем простое количество ядер.
- Поддержка ИИ-инструкций.Intel AMX (Advanced Matrix Extensions) на Xeon 4-го/5-го поколения и поддержка AMD AVX-512/BF16 на EPYC дают CPU реальную возможность инференса на чипе для нагрузок INT8/BF16.
- Линии PCIe.Достаточно линий Gen4/Gen5 для подключения ускорителей, NVMe-накопителей и высокопроизводительных сетевых карт без конкуренции.
- Количество ядер для консолидации.Если на узле также работают совмещённые сервисы, высокая плотность ядер (64–96 ядер) позволяет одному хосту нести инференс и окружающий стек.
EPYC против Xeon как CPU для ИИ-инференса
Две платформы x86 по-разному подходят к поддержке инференса, и обе легитимны — правильный выбор зависит от вашего состава нагрузок и установленной платформенной базы.
AMD EPYC (Genoa и Milan) делает акцент на пропускной способности памяти и плотности ядер.12-канальный DDR5 Genoa обеспечивает примерно на 50 % больше пропускной способности памяти, чем сопоставимая двухканальная платформа, что напрямую снижает голодание ускорителя и ускоряет обслуживание малых моделей только на CPU. Многоядерные SKU, такие какEPYC 7763(64 ядра, Milan) или части Genoa 9004, консолидируют инференс и окружающий стек в одном хосте. Поддержка AVX-512 с BF16 на EPYC чисто закрывает инференс INT8/BF16 на CPU.
Intel Xeon (4-го/5-го поколения) добавляет AMX.AMX — это выделенный матричный блок на кристалле, ускоряющий операции GEMM INT8/BF16 — ядро трансформерного инференса — без дискретного ускорителя. 32-ядерный Xeon 5-го поколения с AMX может обслуживать значительные нагрузки INT8 только на CPU, поэтому экономика инференса только на CPU сместилась в сторону малых и средних моделей.
На практике распространены смешанные парки: AMD EPYC для высокоплотных узлов инференса с высокой пропускной способностью и Xeon там, где лучше подходят AMX и существующие инструменты Intel. Наши линейкиAMD EPYCиIntel Xeonобе покрывают протестированные восстановленные компоненты.
Инференс только на CPU: когда это имеет смысл
Самая рентабельная ИИ-нагрузка — та, которая никогда не покупает GPU. Инференс только на CPU становится всё более практичным в четырёх ситуациях:
- Малые и средние модели— модели классификации, реранкинга, извлечения и энкодеры, которые выполняются за миллисекунды на современном серверном CPU с AMX или AVX-512/BF16.
- Высокопроизводительные нагрузки, терпимые к задержке— пакетный скоринг, где совокупная пропускная способность важнее задержки на запрос.
- Edge- и филиальные площадки— где мощность, охлаждение и стоимость GPU непомерны, а размер модели скромен.
- Переполнение GPU и автоскейлинг— поглощение пиков без выделения дополнительных ускорителей.
Если ваш состав инференса на 70 % состоит из малых моделей, правильно подобранныйCPU для ИИ-инференсасможет обслужить это большинство без каких-либо затрат на GPU, оставив ускорители меньшинству больших моделей. Это самый крупный бюджетный рычаг современной архитектуры инференса.
Построение сбалансированного узла инференса
Когда вы сочетаете CPU с GPU, важны соотношение и топология. Наш опыт сGPU-серверамиуказывает на несколько практических правил:
- Согласуйте пропускную способность CPU с числом ускорителей.Однопроцессорной платформы с 8 каналами достаточно для одной-двух GPU среднего класса; высокоплотным узлам (4–8 GPU) нужен CPU с 12 каналами или двухпроцессорная конфигурация с максимальной пропускной способностью памяти.
- Резервируйте линии PCIe под ускорители и хранилище.Убедитесь, что CPU предоставляет линии Gen5 для GPU и NVMe без разделения.
- Рассчитывайте память под KV-кэш и обслуживание.Сервис инференса требователен к памяти; покупайте ёмкость DDR4/DDR5 щедро по отношению к памяти GPU.
- Оставляйте запас.Буфер загрузки CPU в 15–20 % поглощает пики запросов и накладные расходы оркестрации, не заставляя GPU голодать.
Примеры расчёта: два реалистичных узла инференса
Чтобы сделать рекомендации конкретными, вот два архетипа узлов, которые мы постоянно видим в производственных парках инференса. Расчёт будет варьироваться в зависимости от модели и трафика, но форма сборки последовательна.
Архетип A — узел обслуживания INT8 только на CPU.Для задач классификации, реранкинга и малых энкодеров при умеренной конкурентности однопроцессорный узел с 32-ядерным Xeon 5-го поколения (с AMX) или компонентом класса EPYC 7763 Milan с 64 ядрами, 128 ГБ памяти и двумя NVMe-накопителями обслуживает десятки тысяч запросов в минуту без единого ускорителя. Общая стоимость платформы — доля стоимости стойки с GPU, а энергопотребление остаётся ниже 600 Вт при полной нагрузке.
Архетип B — узел генерации на базе GPU.Для LLM-генерации с двумя-четырьмя ускорителями используйте двухпроцессорный или 12-канальный однопроцессорный CPU с максимальной пропускной способностью памяти, 256 ГБ+ системной памяти для KV-кэша и накладных расходов обслуживания, линии PCIe Gen5, выделенные под GPU, и второй ярус NVMe для весов моделей. Здесь CPU существует, чтобы питать ускорители: пропускная способность и топология PCIe важнее количества ядер.
Оба архетипа разделяют принцип проектирования: рассчитывайте платформу под путь данных, а не только под вычисления. Сервис инференса — это конвейер: разбор входных данных, математика ускорителя, потоковый вывод и хранилище — всё касается CPU. Когда конвейер сбалансирован, загрузка растёт, а стоимость запроса падает; когда нет — самый дорогой компонент стойки простаивает.
Если вы не уверены, какой архетип подходит вашей нагрузке, практичный путь — профилирование: измерьте одновременные запросы, размер модели и целевые задержки, затем сопоставьте их с требованиями к CPU, памяти и ускорителям. Наша команда регулярно проводит покупателей через это упражнение и может предложить протестированную восстановленную конфигурацию, соответствующую профилю.
Измеряйте до покупки.Самый дешёвый способ проверить выбор CPU — телеметрия: запустите репрезентативные запросы, зафиксируйте загрузку CPU, насыщение пропускной способности памяти и PCIe и сравните профиль с целевой задержкой. По нашему опыту работы с корпоративными покупателями, большинство неожиданностей с производительностью инференса сводятся к конкуренции за пропускную способность памяти или PCIe, а не к сырому числу ядер — поэтому расчёт «сначала пропускная способность» стабильно превосходит расчёт «сначала ядра».
Держите прошивку актуальной.Производительность AMX и AVX-512 зависит от ревизий микрокода и BIOS. Восстановленный узел следует обновить до последней поддерживаемой прошивки перед развёртыванием; устаревший микрокод может молча отключить именно те наборы инструкций, которые оправдывают выбор CPU. Мы обновляем прошивку в рамках нашего процесса тестирования и фиксируем ревизию в диагностическом отчёте устройства.
Планируйте вывод из эксплуатации.Оборудование для инференса предсказуемо обесценивается, и тот же трёх-пятилетний цикл обновления, который сделал доступными сегодняшние б/у части EPYC и Xeon, применится и к узлу, который вы строите сейчас. Выбор платформы с глубоким вторичным рынком — серийных SKU на широко распространённых сокетах — сохраняет перепродажную стоимость и будущие возможности апгрейда. Это ещё одна причина, по которой массовые части EPYC и Xeon превосходят экзотические или нишевые SKU за полный цикл владения.
Покупка восстановленных CPU для инференса
Экономика инференса вознаграждает восстановленное оборудование больше, чем обучение: нагрузки меньше, целевые задержки легко достигаются кремнием предыдущего поколения, а требования платформы к памяти/PCIe уже зрелые. Ответственная закупка выведенных из эксплуатации частей EPYC и Xeon требует той же дисциплины, что и любая покупка серверного CPU: проверка OPN, согласованные степпинги для 2P, стресс-тестирование всех ядер и тепловое журналирование. Б/у Milan с 64 ядрами или Xeon 5-го поколения с 32 ядрами с правильной конфигурацией памяти штатно справляется с производственными смесями инференса за долю стоимости новой стойки.
HKCHL поставляет протестированные восстановленные процессоры EPYC и Xeon для инференс-сборок, подтверждает совместимость платформы и может подобрать память и хранилище для завершения узла. Если вы рассчитываете развёртывание инференса и хотите получить практическую вторую оценку по выбору или закупке CPU, наша команда с радостью обсудит ваши требования и предложит конфигурацию, соответствующую бюджету, — будь то узел обслуживания только на CPU или сбалансированная сборка на базе GPU.Свяжитесь с намидля консультации и котировки.