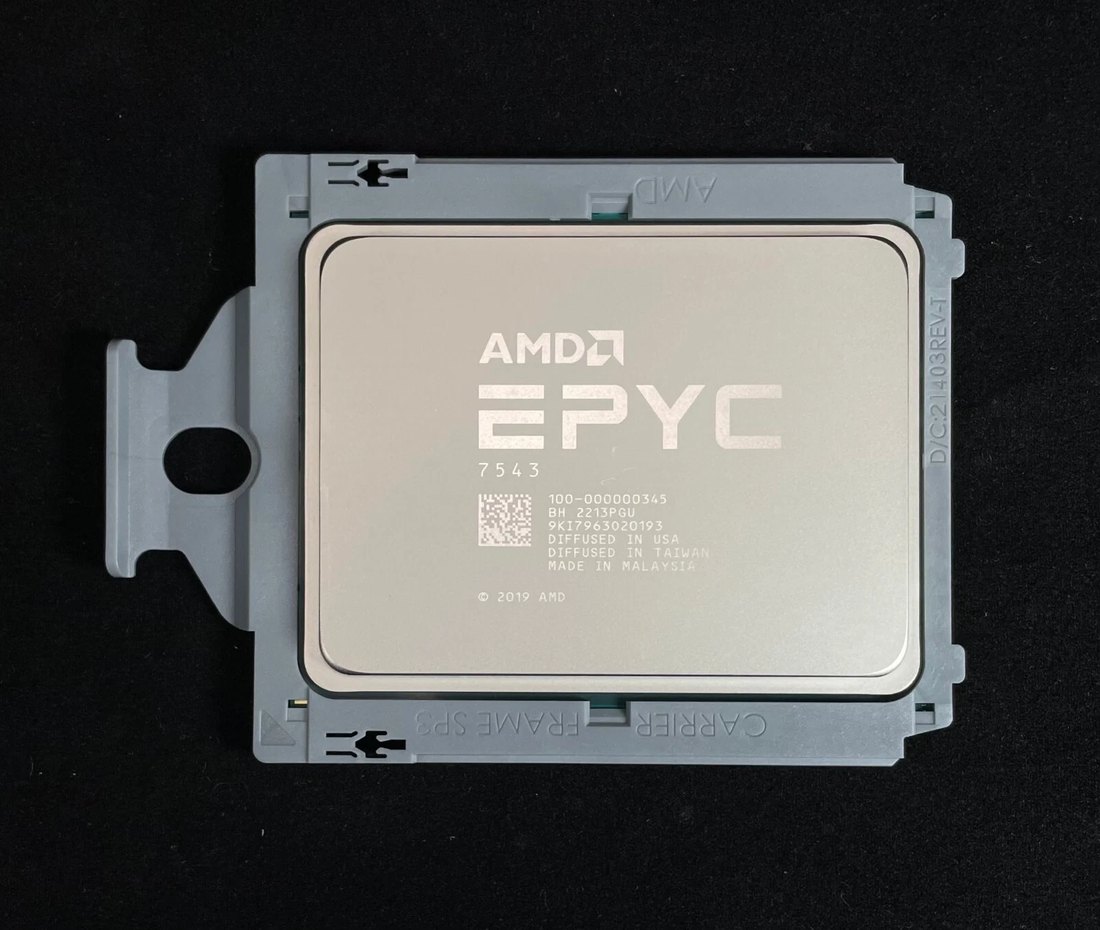
La mayoría de las conversaciones sobre infraestructura de IA empiezan y terminan con las GPU. Ese enfoque es comprensible: los aceleradores realizan la mayor parte del cálculo del modelo. Pero cada solicitud de inferencia también pasa por una CPU: alimenta al acelerador, preprocesa la entrada, ejecuta la lógica de enrutamiento y sirve por sí sola los modelos pequeños. LaCPU para inferencia de IAes una de las decisiones peor dimensionadas en la compra de IA, y el lugar más fácil para gastar de más o quedarse corto de presupuesto.
Según nuestra observación del mercado en despliegues empresariales de inferencia, la elección de la CPU determina silenciosamente tres cosas: cuánto tiempo de inactividad del acelerador tolera, cuántas solicitudes de modelos pequeños atiende sin GPU alguna y cuán preparada para el futuro está su topología de memoria y PCIe. Esta guía explica cómo seleccionar y abastecer unaCPU para inferencia de IAcargas de trabajo en 2026.
Por qué importa la CPU en la inferencia de IA
La inferencia es fundamentalmente distinta del entrenamiento. El entrenamiento es un ejercicio de cómputo paralelo sostenido. La inferencia es sensible a la latencia, está impulsada por solicitudes y es muy variable. Las GPU son excelentes para las matemáticas matriciales densas de un único modelo grande, pero un servicio de inferencia en producción dedica una fracción sorprendente de su tiempo a trabajo que nunca toca el acelerador:
- Procesamiento previo y posterior de las solicitudes.La tokenización, las búsquedas de embeddings, el análisis de salida y el enrutamiento de API se ejecutan todos en la CPU.
- Alimentación de datos.Una GPU que se queda sin datos permanece inactiva a una fracción de su potencial. El ancho de banda de memoria y el rendimiento de PCIe del lado de la CPU determinan la velocidad a la que se alimenta al acelerador.
- Servicio de modelos pequeños.Muchas llamadas de inferencia en producción son modelos pequeños —clasificación, extracción, reordenamiento— donde la latencia y el coste de la GPU no se justifican y la CPU sola es más rápida de principio a fin.
- Orquestación por lotes.Los planificadores, la gestión de KV-cache y el aislamiento multiinquilino se ejecutan en el procesador anfitrión.
Qué buscar en una CPU de inferencia
No toda CPU de servidor es igual de buena para el trabajo relacionado con la inferencia. Priorice estas cinco características:
- Ancho de banda de memoria.En la ruta de CPU, la inferencia está limitada por la latencia y el ancho de banda de memoria. El DDR4 de ocho canales o el DDR5 de doce canales importan mucho más que el número bruto de núcleos en muchas cargas de trabajo de servicio.
- Altas frecuencias de un solo hilo y de boost.El preprocesamiento y la latencia de los modelos pequeños premian los núcleos rápidos por encima del mero número de núcleos.
- Soporte de instrucciones de IA.Intel AMX (Advanced Matrix Extensions) en Xeon de 4.ª/5.ª generación y el soporte de AMD AVX-512/BF16 en EPYC dan a la CPU una capacidad real de inferencia en chip para cargas de trabajo INT8/BF16.
- Líneas PCIe.Suficientes líneas Gen4/Gen5 para conectar aceleradores, almacenamiento NVMe y NIC de alto rendimiento sin contención.
- Número de núcleos para consolidación.Si el nodo también ejecuta servicios colocalizados, una alta densidad de núcleos (64–96 núcleos) permite que un solo host cargue con la inferencia más el stack circundante.
EPYC vs. Xeon como CPU de inferencia de IA
Las dos plataformas x86 abordan el soporte de inferencia de forma distinta, y ambas son legítimas: la elección correcta depende de su combinación de cargas de trabajo y de la base de plataforma instalada.
AMD EPYC (Genoa y Milan) hace hincapié en el ancho de banda de memoria y la densidad de núcleos.El DDR5 de 12 canales de Genoa ofrece aproximadamente un 50 % más de ancho de banda de memoria que una plataforma comparable de doble canal, lo que reduce directamente la falta de datos del acelerador y acelera el servicio de modelos pequeños solo con CPU. Los SKU de muchos núcleos, como elEPYC 7763(64 núcleos, Milan) o las piezas Genoa 9004 consolidan la inferencia y el stack circundante en un solo host. El soporte de AVX-512 con BF16 en EPYC cubre limpiamente la inferencia INT8/BF16 en CPU.
Intel Xeon (4.ª/5.ª generación) aporta AMX.AMX es una unidad matricial dedicada en el die que acelera las operaciones GEMM INT8/BF16 —el núcleo de la inferencia transformer— sin un acelerador discreto. Un Xeon de 5.ª generación con 32 núcleos ejecutando AMX puede atender cargas de trabajo INT8 considerables solo con CPU, razón por la cual la economía de la inferencia solo con CPU ha cambiado para los modelos pequeños y medianos.
En la práctica, las flotas mixtas son habituales: AMD EPYC para nodos de inferencia de alta densidad y alto ancho de banda, y Xeon donde AMX y las herramientas Intel existentes encajan mejor. Nuestras líneasAMD EPYCyIntel Xeoncubren ambas piezas reacondicionadas probadas.
Inferencia solo con CPU: cuándo tiene sentido
La carga de trabajo de IA más rentable es la que nunca compra una GPU. La inferencia solo con CPU es cada vez más práctica en cuatro situaciones:
- Modelos pequeños y medianos— modelos de clasificación, reordenamiento, extracción y encoder que se ejecutan en milisegundos en una CPU de servidor moderna con AMX o AVX-512/BF16.
- Cargas de trabajo de alto rendimiento y tolerantes a la latencia— puntuación por lotes donde el rendimiento agregado supera a la latencia por solicitud.
- Ubicaciones de edge y sucursales— donde la potencia, la refrigeración y el coste de la GPU son prohibitivos y el tamaño del modelo es modesto.
- Desbordamiento de GPU y autoescalado— absorbiendo picos sin aprovisionar más aceleradores.
Si su combinación de inferencia es un 70 % de modelos pequeños, unaCPU para inferencia de IAdebidamente dimensionada puede atender esa mayoría sin gasto alguno en GPU —reservando los aceleradores para la minoría de modelos grandes. Esta es la mayor palanca presupuestaria de la arquitectura de inferencia moderna.
Cómo construir un nodo de inferencia equilibrado
Cuando se combinan CPU con GPU, la proporción y la topología importan. Nuestra experiencia conservidores GPUapunta a algunas reglas prácticas:
- Adecúe el ancho de banda de la CPU al número de aceleradores.Una plataforma de un solo socket y 8 canales es suficiente para una o dos GPU de gama media; los nodos de alta densidad (4–8 GPU) requieren una CPU de 12 canales o de doble socket con el máximo ancho de banda de memoria.
- Reserve líneas PCIe para aceleradores y almacenamiento.Confirme que la CPU ofrece líneas Gen5 para GPU y NVMe sin compartirlas.
- Dimensione la memoria para KV-cache y servicio.El servicio de inferencia consume mucha memoria; compre capacidad DDR4/DDR5 generosamente en relación con la memoria de GPU.
- Deje margen.Un margen de utilización de CPU del 15–20 % absorbe los picos de solicitudes y la sobrecarga de orquestación sin privar de datos a la GPU.
Ejemplos de dimensionado: dos nodos de inferencia realistas
Para concretar las recomendaciones, estos son dos arquetipos de nodo que vemos repetidamente en flotas de inferencia en producción. El dimensionado variará según el modelo y el tráfico, pero la forma de la construcción es consistente.
Arquetipo A — nodo de servicio INT8 solo con CPU.Para cargas de clasificación, reordenamiento y encoders pequeños con concurrencia moderada, un nodo de un solo socket con un Xeon de 5.ª generación de 32 núcleos (con AMX) o una pieza de clase EPYC 7763 Milan de 64 núcleos, 128GB de memoria y dos unidades NVMe atiende decenas de miles de solicitudes por minuto sin ningún acelerador. El coste total de la plataforma es una fracción del de un rack con GPU, y el consumo se mantiene por debajo de 600W a plena carga.
Arquetipo B — nodo de generación respaldado por GPU.Para generación LLM con dos a cuatro aceleradores, use una CPU de doble socket o de un solo socket con 12 canales y máximo ancho de banda de memoria, 256GB+ de memoria de sistema para KV-cache y sobrecarga de servicio, líneas PCIe Gen5 dedicadas a las GPU y un segundo nivel NVMe para los pesos del modelo. Aquí la CPU existe para mantener alimentados los aceleradores: el ancho de banda y la topología PCIe están por encima del número de núcleos.
Ambos arquetipos comparten un principio de diseño: dimensione la plataforma para la ruta de datos, no solo para el cómputo. El servicio de inferencia es una canalización —análisis de entrada, matemáticas del acelerador, transmisión de salida y almacenamiento tocan todos la CPU. Cuando la canalización está equilibrada, la utilización sube y el coste por solicitud baja; cuando no lo está, el componente más caro del rack permanece inactivo.
Si no está seguro de qué arquetipo se ajusta a su carga de trabajo, la vía práctica es perfilarla: mida las solicitudes concurrentes, el tamaño del modelo y los objetivos de latencia, y luego tradúzcalos a requisitos de CPU, memoria y acelerador. Nuestro equipo acompaña regularmente a los compradores en este ejercicio y puede sugerir una configuración reacondicionada probada que se ajuste al perfil.
Mida antes de comprar.La forma más barata de validar una elección de CPU es la telemetría: ejecute solicitudes representativas, capture la utilización de CPU, la saturación del ancho de banda de memoria y el rendimiento de PCIe, y compare el perfil con su objetivo de latencia. En nuestra experiencia apoyando a compradores empresariales, la mayoría de las sorpresas de rendimiento en inferencia se remontan a la contención del ancho de banda de memoria o de PCIe, no al número bruto de núcleos —por eso el dimensionado primero por ancho de banda supera sistemáticamente al dimensionado primero por núcleos.
Mantenga el firmware actualizado.El rendimiento de AMX y AVX-512 depende de las revisiones de microcódigo y BIOS. Un nodo reacondicionado debe actualizarse al firmware compatible más reciente antes del despliegue; un microcódigo anticuado puede desactivar silenciosamente los mismos conjuntos de instrucciones que justifican la elección de la CPU. Actualizamos el firmware como parte de nuestro proceso de pruebas y registramos la revisión en el informe de diagnóstico de la unidad.
Planifique la salida.El hardware de inferencia se deprecia de forma predecible, y el mismo ciclo de renovación de tres a cinco años que abarató las piezas EPYC y Xeon usadas de hoy se aplicará al nodo que construya ahora. Elegir una plataforma con un mercado secundario profundo —SKU de alto volumen en sockets ampliamente desplegados— preserva el valor de reventa y las opciones de actualización futuras. Esta es una razón más por la que las piezas EPYC y Xeon habituales superan a los SKU exóticos o de nicho en un ciclo de propiedad completo.
Comprar CPU de inferencia reacondicionadas
La economía de la inferencia recompensa el hardware reacondicionado más que el entrenamiento: las cargas de trabajo son menores, los objetivos de latencia se cumplen fácilmente con silicio de generación anterior y los requisitos de plataforma de memoria/PCIe ya están maduros. Abastecer piezas EPYC y Xeon dadas de baja de forma responsable exige la misma disciplina que cualquier compra de CPU de servidor —verificación OPN, steppings emparejados para 2P, pruebas de esfuerzo de todos los núcleos y registro térmico. Un Milan de 64 núcleos o un Xeon de 5.ª generación de 32 núcleos usado, con la configuración de memoria adecuada, maneja habitualmente mezclas de inferencia de producción a una fracción del coste de un rack nuevo.
HKCHL suministra procesadores EPYC y Xeon reacondicionados y probados para builds de inferencia, confirma la compatibilidad de la plataforma y puede emparejar memoria y almacenamiento para completar el nodo. Si está dimensionando un despliegue de inferencia y quiere una segunda opinión práctica sobre la selección o el abastecimiento de la CPU, nuestro equipo estará encantado de analizar sus requisitos y diseñar una configuración acorde a su presupuesto —ya sea un nodo de servicio solo con CPU o un build equilibrado respaldado por GPU.Contacte con nosotrospara una consulta y una cotización.